Auf meiner Seite steht jetzt ein Quiz mit dem Titel „Dein erster KI-Mitarbeiter“. Ich wollte, dass man nicht erst lange Texte lesen muss, sondern mit ein paar Fragen herausfindet, wo einem so ein Helfer im Alltag wirklich was abnimmt. Gebaut hab ich das selbst und es läuft auf meiner eigenen Seite, ohne fremdes Quiz-Werkzeug zur Miete. Wer mitmacht, kriegt am Ende eine Auswertung, mit der er selbst weitermachen kann. Probier es einfach mal aus.
Mein Vault ist mein Gedächtnis, und da will ich schnell rankommen, ohne dass irgendwo drei Dienste nebeneinander laufen. Also hab ich die Wissensbasis wieder auf einen einzigen Server zurückgebaut. Den Vault-Lotsen hab ich gemessen und repariert, und die Suche findet jetzt auch ältere Treffer, die READMEs meiner Projekte und meinen eigenen Code. Für mich gilt dabei: erst der Vault, dann der Agent. Wenn ich davon später was anbiete, dann die Hülle und nicht das Wissen, also das Rezept und nicht das Gericht.
Heute ist mein Artikel übers Umschreiben von KI-Texten online gegangen. Mich nervt seit Monaten, dass alle an den Wörtern herumschrauben, obwohl im Text gar keine Aussage steht. Solange da keine Aussage drin ist, bringt das Umschreiben nichts, da kannst du polieren, so viel du willst. Deshalb hab ich alles zusammengetragen: sieben Merkmale, an denen man so einen Text erkennt, vier Schritte, wie man ihn rettet, drei Beispiele und einen Prompt zum Mitnehmen. Der Artikel liegt auf meiner eigenen Seite, nicht auf irgendeiner Plattform, und da bleibt er auch.
Heute ist mein Artikel „Mit KI schreiben: Der Winkel ist die Arbeit“ online gegangen. Die Frage dahinter: Wenn alle mit denselben Werkzeugen schreiben, warum klingt dann trotzdem nicht alles gleich? Meine Antwort ist der Winkel, also der Blick, mit dem man an ein Thema rangeht. Im Artikel zeige ich, wie fünf Blickrichtungen sieben Winkel liefern, mit einem Test, ob der Winkel trägt. Dazu kommen drei Anzeichen, an denen man merkt, ob jemand so einen Winkel überhaupt braucht. Steht wie alles andere auf meiner eigenen Seite, nicht auf einer gemieteten Plattform.
Den Bild-Signierer für VisionFusen hab ich komplett auf TypeScript umgebaut, ohne Python-Skript und ohne fremde Zusatzwerkzeuge. Das Modul steckt jetzt direkt in meinem eigenen Agenten. Der löscht vorher die GPS-Daten, signiert das Bild und schickt den Nachweis an 5 Relays. Das erste echte Bild „Ich sehe dich auch“ hat er heute selbst hochgeladen, und visionfusen.org bestätigt es als echt. Genau so wollte ich das haben: Der Agent macht die Arbeit, nicht ich.
Heute ist mein Artikel zur Push-Benachrichtigung online gegangen. Es geht um eine Frage, die mich selbst geärgert hat: Wie merke ich, dass ein Skript oder eine ganze Automationskette nicht mehr läuft? Die Einstellungen im Betriebssystem reichen dafür nicht, die melden sich nämlich genau dann nicht, wenn es drauf ankommt. Ich zeige, wie Herzschlag-Signale und ein externer Wächter das lösen. Wer seine Abläufe selbst betreibt, bekommt so Bescheid, bevor der Ausfall richtig wehtut.
Heute ist mein Artikel zur Content-Marketing-Strategie online gegangen. Die Frage dahinter höre ich ständig: Straft Google mich ab, wenn ich viel veröffentliche? Meine Antwort ist nein, solange jeder Text etwas Eigenes bringt, also echte Daten und Belege, die man nachprüfen kann. Ärger gibt es erst, wenn die Menge keinen Mehrwert hat. Deshalb prüfe ich bei mir jeden Text gegen feste Belege, bevor er rausgeht.
Heute ist ein Artikel live gegangen, der eine ganz praktische Frage klärt: Wie verhindere ich, dass Inhalte verloren gehen, wenn in einem Headless-System mehrere Leute oder Programme gleichzeitig schreiben? Kennt jeder: Zwei speichern fast zeitgleich, und die Arbeit von einem ist einfach weg. Ich zeige drei Wege, die das abfangen: Optimistic Locking, also erst prüfen, ob sich in der Zwischenzeit was geändert hat, dann Schreibrechte nur so weit wie nötig, und Änderungen in eigenen Git-Branches. Das läuft alles auf meiner eigenen Seite, ohne gemietetes Redaktionssystem dazwischen.
Heute ist mein Artikel zum Thema Video schneiden online live gegangen. Wer danach sucht, landet schnell bei Wasserzeichen, langen Wartezeiten beim Hochladen und Ärger mit der DSGVO. Dabei kann der Browser das längst selbst. Mit WebCodecs, WebAssembly und lokalen Stream Copies bleibt das Video auf dem eigenen Rechner und geht nirgendwo hin. Genau das erkläre ich im Artikel, damit jeder sieht, dass es auch ohne gemieteten Clouddienst geht.
Ich hab mir mit vault-finden eine Volltextsuche gebaut, die meinen ganzen Vault und alle Sitzungen auf einmal durchsucht. Das läuft auf SQLite, ganz ohne fremden Dienst, und neuere Notizen landen weiter oben. Abgelaufene Sachen zählen nur halb, und Umlaute sind egal, ob ich ä oder ae tippe. 2.337 Notizen sind in 0,2 Sekunden durch. Jetzt finde ich auch alte Fehler samt Lösung wieder, statt sie zum zweiten Mal zu lösen.
Heute hab ich angefangen, meine ganze Kette neu zu bauen, vom ersten Gedanken über Suchvolumen, Entwurf und Prüfung bis zur fertigen statischen Seite. Der Grund ist einfach: Die alte Kette ist mir heute gleich mehrfach still leer gelaufen, und keiner hat es gemerkt. Das neue System heißt gedankenwerk und läuft in TypeScript auf Mastra, das Gerüst steht schon. Die Regel dafür ist klar: Jede Stufe muss beweisen, dass sie gearbeitet hat, und wenn was ausfällt, krieg ich sofort eine Nachricht aufs Handy. Wenn alles steht, läuft es sieben Tage im Schatten neben dem alten System, dann schalte ich am selben Tag um.
Ich hab einen Fachartikel zum Claude Limit online gestellt. Die Frage kriege ich ständig: Warum ist plötzlich Schluss, obwohl man gefühlt kaum was gemacht hat? Der Grund ist, dass sich die Token in einer langen Unterhaltung aufsummieren, und dann greifen das 5-Stunden-Fenster und das Wochenkontingent. Im Artikel erkläre ich, wie das zusammenhängt und wie man die Zwangspause vermeidet. Liegt bei mir auf der eigenen Seite, nicht irgendwo auf einer gemieteten Plattform.
Heute ist mein Artikel zum Thema KI lernen online gegangen. Mir geht es auf die Nerven, dass überall Tool-Kataloge und Prompt-Tricks verkauft werden, als wäre das schon die halbe Miete. Ich zeige stattdessen, was wirklich trägt: verstehen, wo die Maschine gut ist und wo nicht, also die Jagged Frontier aus der Studie von Harvard und BCG. Dazu kommt saubere Textarbeit und eine klare Aufteilung, wer was macht, Mensch oder Maschine. Wer so einsteigt, hat etwas in der Hand, das auch beim nächsten Werkzeug noch funktioniert.
Ich habe heute einen Artikel online gestellt, wie man Versionskontrolle und Datensicherung in Framer hinbekommt, obwohl Framer keinen Code rausgibt. Die Frage hat mich selbst umgetrieben, weil meine eigene Seite mit Framer gestaltet ist. Laut den AGB bist du für deine Sicherung selbst verantwortlich, die Werkzeuge dafür kriegst du aber nicht. Ich zeige, wo das Branching in Framer an seine Grenzen stößt und wie man die Seite trotzdem in ein eigenes Git spiegelt. Am Ende liegt die Seite bei mir und läuft auch ohne Framer weiter. Genau darum geht es mir: selbst gebaut statt gemietet.
Heute ist mein Artikel über das Entwickeln in schreibgeschützten Sandboxes online gegangen. Das Problem kennt jeder, der mit Agenten oder abgeschotteten Umgebungen arbeitet: Man darf nichts anfassen, also wird erst mal alles kopiert. Das geht auch anders, nämlich mit OverlayFS samt Metacopy, Symlink-Wäldern wie bei Bazel, Git-Alternates und umgeleiteten Caches. Ich hab zusammengeschrieben, wie diese Werkzeuge zusammenspielen, damit man schreiben kann, ohne das Original zu verändern. Das ist kein gemieteter Dienst, nur Bordmittel, die schon da sind, wenn man weiß, wo man sie findet.
Jeden Morgen um 6:00 schlägt mir mein eigener Befehl jetzt mindestens drei Ideen vor, aus meiner Keyword-Liste und aus dem, was ich am Vortag in meinen Sitzungen gesagt habe. Neu dazugekommen ist sitzungs-themen: Das Ding nimmt meine wörtlichen Sätze, macht daraus Themenfelder und schaut im Google-Anzeigenplaner nach, ob überhaupt jemand danach sucht. Was keiner sucht, fliegt raus, und was schon alle bedienen, fliegt auch raus. Kein Geld für Köder, wo keine Fische sind. Der Probelauf zum 17.10. hat aus 13 Feldern und 4.152 Begriffen genau 5 Treffer geholt, darunter deepfake erkennen und browser anonym.
Heute ist mein Artikel über Software-Dokumentation online gegangen. Die Frage dahinter kenne ich aus eigenen Projekten: Was passiert, wenn Kunde und Entwickler unter derselben Anforderung etwas anderes verstehen? Ich habe mir angeschaut, wie der BGH das bei der Mängelhaftung sieht, wer nach § 363 BGB was beweisen muss und warum es dabei schon um Schäden bis 750.000 Euro ging. Dazu kommt der Kriterienkatalog vom LSG Baden-Württemberg, weil eine saubere Spezifikation auch gegen den Verdacht auf Scheinselbstständigkeit hilft. Wer als Freiberufler Software baut, sollte die Doku als Teil der Arbeit sehen und nicht als lästige Pflicht hinterher.
Ich habe auf stevennoack.de eine eigene Bio-Seite unter /links gebaut. Statt eines gemieteten Linkdienstes stehen meine Links jetzt auf meiner eigenen Seite, zum Beispiel zu Substack und in48stunden. Oben steht ein kurzer Satz über mich mit einem kleinen Profilbild, darunter folgen schlichte Kacheln mit kurzen Namen. Dazu ist ein neuer Kasten für Artikel live gegangen, damit man gleich sieht, was ich zuletzt geschrieben habe. Die Seite gehört mir, und ich kann sie jederzeit ändern, ohne jemanden um Erlaubnis zu fragen.
Heute ist mein Artikel zur Software-Dokumentation online gegangen. Darin geht es um eine Frage, die viele Freiberufler unterschätzen: Wenn die Spezifikation Lücken hat und es keine Abnahme gibt, liegt die Beweislast schnell bei dir. Beim Werkvertrag kann dich das dein Honorar kosten. Ein Fall, den ich mir angeschaut habe, endete mit einer Forderung von 750.000 €. Wer sauber dokumentiert, hat am Ende etwas in der Hand. Darum gehört die Doku für mich zum Werk dazu und ist kein Anhang.
Meine Prüfung hat gemeldet, dass ein Artikel fehlgeschlagen ist. Der Artikel war aber die ganze Zeit online, es fehlten nur die Nostr-Datei und der Eintrag in der llms.txt. Die Ursache war banal: Auf dem Rechner war Wrangler gar nicht installiert, deshalb ist jeder automatische Deploy beim Nachziehen gescheitert. Ein npm install, und die Gesamtprüfung meldet jetzt 29 Artikel und 0 Lücken. Nebenbei habe ich den Logbuch-Generator repariert, der meine Handkorrektur immer wieder überschrieben hat. So was passiert eben, wenn man seine Kette selbst baut, aber dafür weiß ich auch genau, wo ich schrauben muss.
Ich habe Spotify auf meinem Mac mit Spicetify erweitert, dazu DJ Mix, adblockify, Marketplace und dj-info. Den Code jeder Erweiterung habe ich mir vorher angeschaut, und die reden nur mit Spotify. Spicetify kam direkt von GitHub, weil Homebrew auf dem Intel-Mac erst Python aus dem Quellcode bauen wollte. DJ Mix sortiert meine Playlists nach Camelot, BPM und Energiebogen, und das taugt richtig gut. Übergänge macht es nicht, dafür nehme ich bei eigenen Dateien lieber Mixxx.
In meinem Vault gab es eine Liste offener Punkte, die nie kürzer wurde. Ein Punkt ging nur weg, wenn ihn jemand als erledigt markiert hat, und was eingeschlafen ist, blieb für immer stehen. Jetzt fragt das System gestaffelt nach, nach 14, 30, 42, 49 und 56 Tagen, und ich sage bleibt oder weg. Danach ruht der Punkt in einer eigenen Datei und ist aus meinem täglichen Blick raus. Gelöscht wird dabei nichts, der Punkt bleibt in seiner Notiz stehen.
Heute ist der zweite Teil meiner Reihe KI für Selbstständige rausgegangen, Stufe 2 von 8. Es geht um die ersten drei Schritte im Arbeitsalltag: lange Dokumente verdichten, die Centaur-Methode nach Harvard und BCG und den Datenschutz dicht machen, bevor man überhaupt den ersten Prompt schreibt. Mir war wichtig, dass man das am nächsten Morgen einfach ausprobieren kann, ohne erst ein Handbuch zu lesen. Gerade der Datenschutz kommt bei den meisten zu spät, deshalb steht er bei mir vor dem ersten Prompt und nicht danach. Wer mit KI bisher wenig anfangen kann, soll hier sehen, wie man die Technik selbst in die Hand nimmt.
Mein RAG-System hat einer Unsinnsfrage denselben Wert gegeben wie einer echten Frage. Das hat mich geärgert, denn dann erfindet die Antwort etwas, statt ehrlich zu passen. Also habe ich einen Reranker und Jev dazwischengesetzt, die solche Fragen abfangen. Gemessen habe ich das an 35 Fragen, und wie das ausging, steht jetzt im Artikel. Alles läuft bei mir selbst, nichts davon ist gemietet.
Heute ist mein Artikel zu Googles AI Overviews online gegangen. Mich hat interessiert, warum manche Seiten in diesen KI-Antworten als Quelle auftauchen und andere nicht. Die Antwort ist ziemlich nüchtern: Die zitierten Quellen kommen aus den organischen Top 20, wer da nicht steht, ist auch in der Antwort nicht drin. Dazu kommt ein Einbruch der Klickrate um 59 Prozent, das tut weh. Was trotzdem hilft, sind eigene Primärdaten, also Zahlen, die es nur bei dir gibt. Genau deshalb steht das auf meiner eigenen Seite und nicht auf einer gemieteten Plattform.
Mein Plugin helfer-band ist in Version 0.2.0 im Plugin-Verzeichnis von Anthropic eingereicht, jetzt schaut sich das ein Mensch an. Vorher habe ich die README aufgeräumt, da stehen jetzt alle Dateien, Programme und Abrufe drin, die das Plugin anfasst. Da stand nämlich vorher „schreibt keine Dateien“, und das stimmte nicht, das hat die Prüfung im Portal gefunden. Updates holt sich das Plugin alle 6 Stunden selbst ab, ohne Webhook, damit kein Geheimnis übers Netz muss.
Bisher kam einmal pro Woche ein Artikel raus, ab jetzt soll es jeden Tag einer sein. Das tägliche Veröffentlichen habe ich selbst gebaut, 11 Tests sind grün. Vorher habe ich den Testmüll aus dem Artikelordner und dem Vault geräumt, damit nichts Halbes rausgeht. Und weil es schon an mehreren Tagen doppelte Logbuch-Einträge gab, vergleicht die Sperre jetzt Links statt Titel, mit und ohne Schrägstrich am Ende.
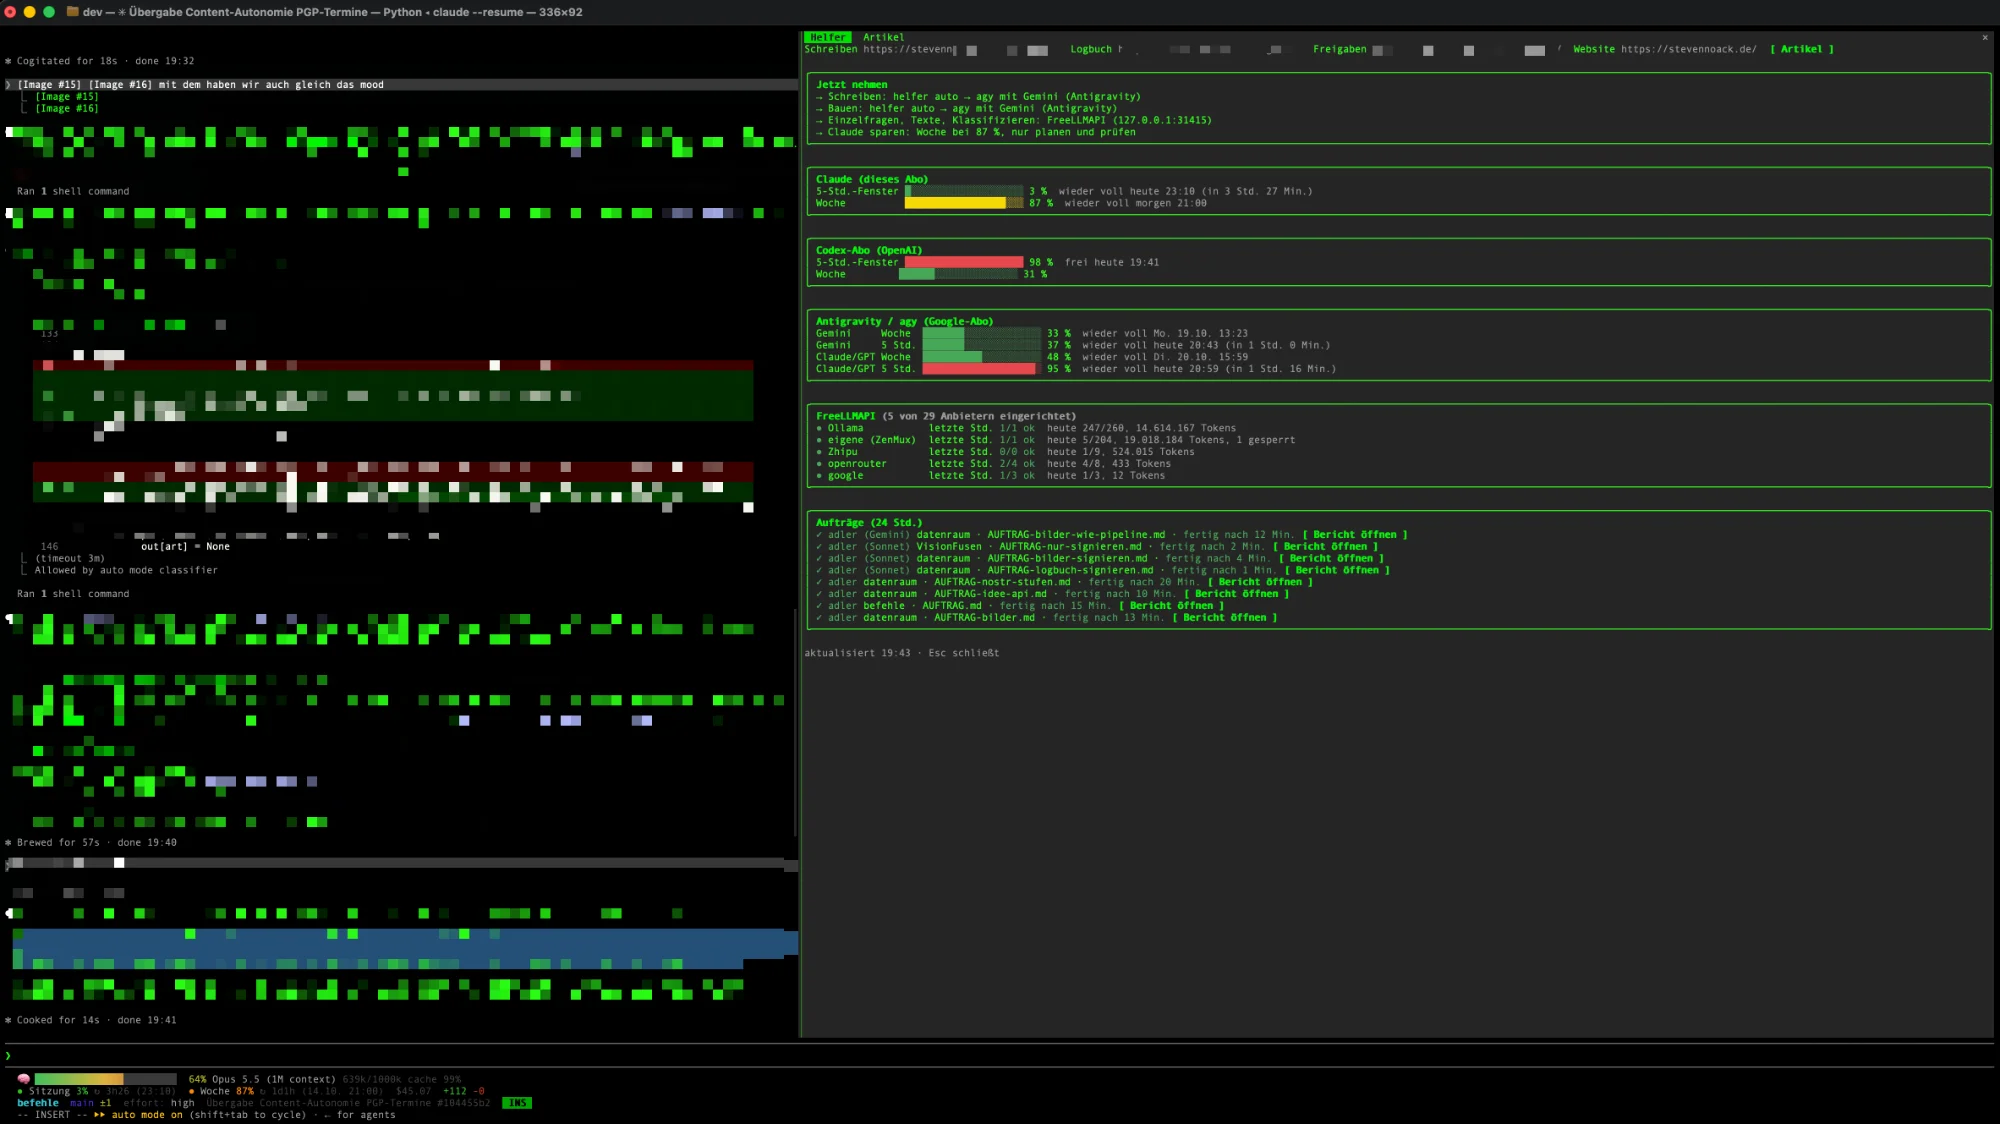
So sieht es aus. Rechts im Terminal sehe ich meine Helfer: wer gerade läuft, wie lange noch und wo noch Kontingent frei ist. Gebaut als Mod in Claude Code. Die Zahlen holt ein Skript, das kostet keine Tokens.
Andere malen oder komponieren. Ich baue Werkzeuge.
Heute zum Beispiel: Ich wollte im Terminal sehen, was meine Helfer gerade machen. Codex, Gemini, die Gratis-Modelle. Wer läuft gerade, und wo ist noch Kontingent frei?
Jetzt hab ich ein Dashboard in Claude Code. Mit einem Balken für jedes Abo und einer Zeile pro Auftrag. Das läuft über ein Skript, Tokens kostet es also nicht.
Cal.com ist seit April 2026 Closed Source, also hab ich mir angeschaut, was man stattdessen selbst betreiben kann. Im Artikel vergleiche ich Cal.diy, Tymeslot, Calnode und Easy!Appointments. Calnode hab ich selbst getestet: 64 MB Image, 85 MB Arbeitsspeicher, und die Buchungsseite schickt keine Anfragen an Dritte. Deshalb läuft meine eigene Terminbuchung auf stevennoack.de seit heute auf Calnode statt auf Cal.com im Abo. Der Artikel ist für alle, die gerade vor derselben Frage stehen.
Mein Artikel über typisierte Entscheidungen ist jetzt online. Es geht um Jev, ein Werkzeug, das keinen Fließtext zurückgibt, sondern einen Wert aus einer festen Auswahl. Ich erkläre, wann ein Sprachmodell mit Schema die bessere Wahl ist, und gebe eine Bauanleitung mit sieben Regeln dazu. Gemessen hab ich selbst: 40 typisierte Fragen, 121 Aufrufe, 20 von 20 richtig. Der Text lag drei Wochen fertig herum, weil mir der Schritt zum Veröffentlichen gefehlt hat.
Auf pgp.stevennoack.de kannst du jetzt selbst ausprobieren, wie ein Login ganz ohne Passwort und ohne E-Mail funktioniert. In fünf Etappen erzeugst du im Browser dein eigenes PGP-Schlüsselpaar und gibst nur den öffentlichen Schlüssel ab. Zum Anmelden bekommst du einen verschlüsselten Einmal-Code, den nur du mit deinem privaten Schlüssel aufmachen kannst. Der Server speichert nur öffentliche Schlüssel, da gibt es also nichts Geheimes zu klauen. So melden sich Leute übrigens auf Plattformen im Darknet an, und ich wollte, dass man das einmal mit eigenen Händen erlebt, statt es nur erklärt zu bekommen.
Heute ist mein Artikel über den Login mit PGP-Schlüssel statt E-Mail online gegangen. Ich erkläre darin, wie Plattformen im Darknet das machen, und stelle es dem normalen Web gegenüber, wo die E-Mail-Adresse der Generalschlüssel zu allem ist. Dazu kommt der Vergleich mit Passkeys und Nostr, und ich schreibe auch auf, wo die Schwächen liegen, belegt mit 34 Quellen. Meine Lernseite pgp.stevennoack.de hat außerdem einen Weg ganz ohne JavaScript bekommen, damit man sie auch im Tor Browser durchspielen kann. Und in der Challenge steht jetzt die Domain mit drin.
Ich lasse viel Kleinkram von Helfern erledigen, und bisher wusste ich nie so genau, wer gerade was macht. Deshalb hab ich mir ein Band gebaut, das direkt über meiner Eingabezeile in Claude Code sitzt und mir zeigt, welche Aufträge laufen und was sie verbrauchen. Dazu gibt es eine eigene Übersicht, falls ich mehr sehen will. Die Daten holt ein kleines Skript, da läuft kein Modell mit. Das Ganze liegt jetzt als Plugin auf GitHub, wer Claude Code nutzt, kann es sich einfach dazuholen.
Heute habe ich mir die erste Bilanz nach dem Umzug auf Vercel angeschaut: 50 Cron-Läufe, alle mit Status 200. Dabei ist mir aufgefallen, dass der alte Runner auf dem iMac heimlich wieder mitlief. macOS hatte ihn bei der Anmeldung neu geladen, weil die plist noch im Ordner lag. Jetzt ist er komplett raus, mit seinen Skripten und der lokalen Datenbankkopie von rund 925 MB. Außerdem schreibt der Digest jetzt eine Zeile ins Log, wie viele Mails rausgegangen sind. Ins Postfach muss ich dafür nicht mehr schauen.
Bei rbde habe ich den alten Bestand sortiert. Von 27.856 Einträgen ohne Art sind nur noch 5 übrig, und 83 Produkte haben eine Kategorie bekommen. Alte Zweige und tote Clerk-Verweise sind raus, übrig ist nur noch main. Alle 703 Tests sind grün, auf Vercel läuft der aktuelle Stand. Der Code lag bisher nur auf dem iMac, jetzt liegt er zusätzlich in einem privaten GitHub-Repo.
In meine Befehlssammlung sind zwei neue Werkzeuge dazugekommen: git-aufraeumen räumt alte Zweige weg, rbde-kurzfassung-stand zeigt, wie weit die Kurzfassungen sind. Beide sind gebaut und getestet. Ein Aufruf mit vier Zeilen ersetzt zehn Einzelschritte, das spart Zeit und Rechenkosten. Nebenbei ist Docker Desktop vom iMac geflogen, docker läuft jetzt über OrbStack.
Wenn jemand auf updatefeed.de eine Anbieter- oder Produktseite aufmacht, holt die Seite deren Quellen in dem Moment frisch ab. Höchstens 5 pro Besuch, und jede Quelle höchstens alle 15 Minuten. Bots und curl lösen dabei nichts aus, das läuft nur bei echten Besuchern. Dazu gibt es jetzt eine Seite mit allem, was in den letzten 24 Stunden neu reingekommen ist. Die bleibt offen, ohne Anmeldung, weil die Daten über RSS sowieso frei sind. Wer mehr will, legt sich Mein Feed an.
Auf updatefeed.de war die Seite /daten richtig zäh, das Beispiel hat 20 Sekunden gebraucht. Jetzt ist es in 0,3 bis 1,4 Sekunden da. Schuld war eine einzige Abfrage, die jede Herstellerseite für sich neu gerechnet hat, und ein Suchprogramm hat das ständig angestoßen. Die Übersicht wird jetzt höchstens einmal pro Stunde gerechnet und fertig. Den Login hab ich gleich mit umgebaut: Anmeldung mit E-Mail-Code, selbst gebaut, und Clerk ist komplett raus.
Ich bau mir gerade mein eigenes Werkzeug für Substack, das im Terminal läuft und meine Daten bei mir speichert statt nur abzufragen. Kommentare und Antworten liegen jetzt im Volltext auf meinem Rechner, 197 unter Beiträgen und 169 unter Notes. Daraus rechnet es aus, wem ich noch eine Antwort schulde, gerade sind das 38. Der Leitsatz dabei ist einfach: Haben ist besser als brauchen. Von allein kommentieren tut das Werkzeug nicht, das bleibt meine Sache.
Mein Dienst für Release-Meldungen, rbde, hat jetzt eine eigene Schnittstelle mit fünf Endpunkten unter /api/v1 und drei RSS-Feeds: einen für alles, einen je Hersteller und einen je Produkt. Die Suche geht nach der Bedeutung, also findet eine deutsche Anfrage auch englische Releases. Den Suchindex habe ich umgestellt, er ist von 826 auf 142 MB geschrumpft und findet trotzdem 9,9 von 10 Treffern. 172 Tests sind grün, und sichtbar sind 7.568 echte Releases. Die Quellen hole ich selbst ab, ich halte mich an robots.txt und schreibe nicht beim Mitbewerber ab.
Mit ModForge will ich prüfen, ob meine Skills wirklich was taugen. Heute lief der erste echte Vergleich an meinem Skill stack-guardrails: Das Original kam auf 63,5 %, die gekürzte Fassung nur auf 43,0 %. Das Original bleibt also, kürzer ist nicht automatisch besser. Die Datenbank dahinter ist Turso, und weil es das Paket nicht für meinen Intel-Mac gab, hab ich es selbst aus Rust gebaut. Die Bewertung macht kein Sprachmodell, sondern Jev, weil das schneller und billiger war und ehrlich sagt, wie sicher es sich ist.
Wenn mir eine Seite gefällt, will ich wissen, wie sie gebaut ist, und nicht ihre Texte klauen. Dafür gibt es jetzt den Befehl nachbau-scan und einen passenden Skill. Vorher hab ich geschaut, was es schon gibt, lokal, auf skills.sh und auf GitHub, und keiner davon schaut auch ins Backend. Als Erstes hab ich Releasebot zerlegt, nach Seitenarten, Bauteilen und Logik, alles in eigenen Worten. Am Ende steht ein Bauplan, mit dem ich so was selbst nachbauen kann.
Ich wollte wissen, was in den Skills auf skills.sh wirklich drinsteckt. Also habe ich mir ein eigenes Werkzeug gebaut, das jeden Skill samt Originaldatei, Lizenz und Herkunft in meine eigene Datenbank zieht. Danach habe ich 98 Skills nach 13 Merkmalen bewertet. Bei 88 von 98 fehlt dasselbe: eine eigene Prüfung, ob der Skill überhaupt funktioniert. Einen Versuch, sie zu modernisieren, habe ich wieder gestoppt, weil der Gewinn unter 5 Prozentpunkten lag. Und für den deutschsprachigen Raum ist fast nichts dabei, das merke ich mir.
Ich hatte 15 Berichte über KI-Arbeitsmärkte gesammelt und wollte wissen, was davon stimmt. Also habe ich die Originale gelesen und 22 Behauptungen gegengeprüft. Dabei kam raus, dass manche Zahl der falschen Quelle zugeschrieben war und ein Bericht eine Marktgröße wohl erfunden hat. Den Markt, auf dem Agenten Menschen beauftragen, gibt es kaum: Bei RentAHuman sind 0,8 % der Plätze besetzt. Und 9 Modelle als Richter zählen etwa so viel wie 2 unabhängige Stimmen, weil sie dieselben Fehler machen.
In der Nacht ist meine eigene SEO-Werkzeugkiste entstanden, 13 Befehle, alles kostenlos. Angefangen hab ich mit Nachbauten von OpenSEO, also Keyword-Ideen, SERP-Vorschau, Domain-Alter oder Backlinks. Dann kamen Sachen dazu, die ich so nirgends gefunden hab: ein Frühwarner für neue Suchbegriffe, ein Nischen-Gewinner und einer, der tote Wikipedia-Links aufspürt. DataForSEO kommt mir nicht rein, die letzten Lücken hab ich auch ohne bezahlte Daten geschlossen. Der Backlink-Befehl fragt zehn Quellen ab und findet tatsächlich den echten Link von wuwaivibe.dev auf raidkrake.de. Der Frühwarner läuft jetzt jeden Morgen um 7:30 Uhr von selbst.
Heute sind auf in48stunden.de neue Wissensartikel live gegangen. Es geht um die Fragen, die mir kleine Betriebe immer wieder stellen: Was kostet eine Webseite, wem gehört sie am Ende, lohnt sich der Umstieg von WordPress und warum findet Google die neue Seite nicht. Jeder Artikel ist gegen meine eigenen Fachtexte geprüft, bevor er rausging. Wer mit einem Agenten vorbeikommt, kriegt unter derselben Adresse eine saubere Markdown-Fassung. So schicke ich bei der nächsten Frage einfach einen Link, statt alles neu zu erklären.
Statt ein CRM zu mieten, habe ich mir eins selbst gebaut, mit Rails und SQLite auf meinem eigenen Rechner. An einem Tag stand es, und 2.951 Betriebe aus drei Ziellisten sind schon drin. Das Datenmodell ist bewusst schlicht, Betrieb, Person, Verlauf, und die Wiedervorlage hängt direkt am Betrieb. Wenn ich nochmal importiere, verdoppelt sich nichts, und mein Status und meine Notizen bleiben stehen. Kalte Werbemails gibt es bei mir nicht, ohne Einwilligung geht der erste Kontakt als Brief raus.
Raidkrake ist umgezogen und läuft jetzt auf meinem Server bei Hetzner in Nürnberg. Wenn im Chat einer !raid tippt, kommt die Antwort direkt von dort. Seit 0:09 Uhr sichert Litestream die Datenbank laufend nach R2, und der Zugang dafür kommt nur an diesen einen Bucket ran. Den AV-Vertrag mit Hetzner hab ich abgeschlossen, in der Datenschutzerklärung stehen jetzt Hetzner und Nürnberg. Das ist mein eigener Bot mit meinem eigenen Code, kein Dienst von der Stange.
Die Seite wuwaivibe.dev ist jetzt erreichbar. Die Weiterleitungen hab ich geprüft, und auch die Mail an hallo@ kommt an. Nach außen trete ich trotzdem weiter als Raidkrake auf. Ein eigenes wuwAIvibe-Konto lege ich erst an, wenn ein zweites Produkt dazukommt.
Ich hab in48stunden.de mal neben stevennoack.de gelegt. Das HTML war sauber, aber die Seiten brauchten 0,45 bis 1,6 s, weil kein Cache dran war. Jetzt hängt der Workers Cache davor, und die Seiten sind in rund 0,2 s da. Admin, Setup und 404-Seiten laufen am Cache vorbei, und was ich auf den Zweig schiebe, geht von selbst online. Dabei hab ich gelernt, dass der Cache dem Worker gehört und nicht der Domain, denn eine falsch gesetzte Weiterleitung hat mir für ein paar Minuten die Startseite weggeschossen.
Ich hab mir einen Skill gebaut, der LinkedIn-Posts schreibt, und zwar so, dass jede Behauptung belegt sein muss. Im Fakten-Modus recherchiert er erst und schreibt dann mit Quellen. Ein unabhängiger Review hat fünf Sätze gefunden, die zu weit gingen, obwohl die Quellen selbst stimmten. Seitdem gilt: Im Rat-Absatz stehen keine unbelegten Aussagen über Leser, Zahlen oder Ursachen. Jeder kann den Skill jetzt mit npx skills add MacStenk/skills installieren, das hab ich von außen getestet.
Meine Seite in48stunden.de läuft jetzt auf der EmDash-Marketingvorlage, mit meinen eigenen Inhalten aus der alten Sicherung. Startseite, Über mich, Kontakt, Impressum und Datenschutz sind drin, vorne steht „Der Countdown läuft.“ Alte Adressen und 48std.de leiten dauerhaft auf die neue Seite weiter, da geht also kein Link verloren. Am Morgen hatte ein Agent schon mal einen Stand hingestellt, aber das hier ist tausendmal schöner. Als Nächstes schreibe ich die Startseite aus meiner Positionierung neu.
Mein Vault hat jetzt ein eigenes Inhaltsverzeichnis, die Datei llms.txt. Ein kleines Skript baut sie im Nachtlauf neu, dazu eine große Fassung mit 1.455 Notizen. Drin stehen nur Pfad, Titel und eine kurze Beschreibung, nichts Privates. Die alte Version vom Dezember 2025 kannte gerade mal 56 von rund 1.740 Notizen. Der Anlass war ärgerlich: Eine Lehre stand plötzlich doppelt drin, weil die Projektnotizen in keinem Verzeichnis auftauchten. Jetzt wird vor jeder neuen Notiz erst im Index gesucht.
Ich wollte wissen, ob Jev, mein Werkzeug fürs Grobsortieren, gegen ein großes Modell besteht, und hab die Zahlen nachgesehen. In der Demo schafft Jev 384 Schlagzeilen in 24,9 Sekunden für 0,19 Dollar. Opus 5 bringt im selben Lauf vier Schlagzeilen für 0,77 Dollar. Bei 176 Signalen lag die Übereinstimmung bei 76,7 Prozent, und jede Abweichung ging in die sichere Richtung. Jev ist wie ein Professor, der wenig kann, das aber schnell, billig und im Zweifel vorsichtig. Fürs Katalogisieren und für Ja oder Nein nehme ich ab jetzt ihn.
Am Abend lief im Chatraum der Raum Hidden Hand komplett durch, alle 638 Zeilen von 21:45 bis 00:01. Danach habe ich die Neuerungen auf den Server gespielt. Wer jetzt hochscrollt, um was nachzulesen, wird nicht mehr nach unten gerissen, es gibt einen Knopf „↓ Neue Zeilen“. Am Handy ist der Kopf zugeklappt und zeigt nur noch, wie viele gerade im Raum sind. Klingt nach Kleinkram, aber genau das hat beim Mitlesen am meisten genervt.
Ich wollte sehen, welche Ports und Prozesse bei mir gerade laufen, und hab das passende Dashboard gesucht. Davon hab ich inzwischen mehrere, nur konnte keins genau das. Mein Satz dazu war: „Ich brauche ein Dashboard für die Dashboards.“ Gebaut hab ich dann bewusst keins, sondern den Befehl ports. Der erzeugt auf Abruf eine frische Seite mit Reitern für alles, was läuft und was aus ist, und macht sie auf. Kein neuer Dienst, kein neuer Port, nichts, was nebenher mitläuft.
Ich hab heute meine eigene Liste mit praktischen KI-Werkzeugen auf GitHub gestellt, sie heißt awesome-practical-ai. Aufgebaut ist sie nach dem Standard von Sindre Sorhus, mit freier CC0-Lizenz und klaren Regeln, wie man etwas beitragen kann. Sechs Einträge sind schon drin, darunter CC Switch, Scrapling und Composio. Warum ich das mache: Ich weiß oft selbst nicht, wonach ich suchen soll, und die großen Verzeichnisse verlinken dieselben Sachen mehrfach. Neue Funde kommen direkt rein, ohne Zwischenlager, denn ein Commit lässt sich leicht korrigieren. Und nebenbei lerne ich GitHub an einem echten Projekt statt an einer Übung.
Neben der Liste gibt es jetzt ein zweites Repo, practical-ai-skills, nur für meine eigenen Skills. Die gehören nicht in die Liste selbst, dort steht nur ein Link drauf. Der erste Skill heißt stack-guardrails. Ich hab ihn mit npx skills add getestet, und er wurde sauber gefunden. Damit holt sich jeder den Skill mit einem Befehl, statt ihn irgendwo abzuschreiben.
Im Chatraum sieht man jetzt, welche Bekannten gerade online sind und welche nicht. Diese Liste bekommt aber nur, wer sein eigenes Profil anschaut, Fremde und Gäste sehen davon nichts. Bei ICQ war das genauso, da hat auch keiner sein Beziehungsnetz für alle freigegeben. Mir war wichtig, dass die Liste wirklich weg ist und nicht bloß versteckt: Im HTML, das vom Server kommt, steht sie für andere gar nicht mehr drin. Das läuft auf meinem eigenen Server bei Hetzner, und alle 207 Tests sind grün.
Nachts hab ich mir lokale Sprachausgabe vorgenommen, mit Qwen3-TTS über llama.cpp, auf dem T480 und auf dem iMac. Ich hab richtig mitgemessen, und siehe da: Über die Grafikeinheit war es fast doppelt so langsam wie auf der CPU, also rechnet das jetzt auf der CPU. Der iMac ist praktisch gleich schnell wie der T480, und mehr Threads machen es sogar langsamer. Texte laufen am Stück durch, weil jede Teilung das Modell neu lädt und Zeit kostet. Am Ende steht ein Skript mit Anleitung, und ich brauch für Vorlesen keinen Dienst mehr, den ich jeden Monat bezahle.
Ornith-9B läuft jetzt auf meinem iMac, starten und stoppen mache ich mit einem kleinen Skript. Es hängt in OpenWebUI und kann über SearXNG im Netz suchen, ganz ohne fremden Anbieter dazwischen. Auf dem T480 hab ich das große Ornith-35B gegen Qwen antreten lassen. Gleiche Punktzahl, aber Ornith ist anderthalbmal so schnell und denkt fünfmal kürzer. Also bleibt Ornith da drauf.
Bevor ich am Chatraum weiterbaue, wollte ich wissen, wo was liegt. iMac und Server standen auf demselben Stand, GitHub hing 31 Commits hinterher. Jetzt liegt der Code im privaten Repo, und eine benannte Marke hält den heutigen Stand als Rückweg fest. Gesichert wird auf drei Wegen: auf dem Server, auf meiner externen Platte und später bei Cloudflare R2. Auf der Platte liegen schon 14 Tagessicherungen. Öffentlich wird der Code erst, wenn die Sicherheitsprüfung durch ist.
Vorher hab ich vier Stunden mit OneDev rumprobiert und alles wieder abgeräumt, weil mein Vault über GitHub das längst kann. Fünfmal hab ich gefragt, wo meine Sitzungen eigentlich gespeichert werden, jetzt weiß ich es und hab ein kleines Skript dazu. Nach jeder abgeschlossenen Aufgabe schreibt es eine Notiz in meinen Vault, mit meinen Fragen wörtlich und dem, was dabei rauskam. Da denkt nichts mit, das Skript schreibt nur ab. Das Verdichten macht der Nachtlauf um 20:45 und schlägt mir vor, was davon ein Werkzeug zum Wiederverwenden werden könnte. Läuft auf dem iMac und auf dem MacBook, GitHub bringt beides zusammen.
Nachts um vier war meine Gedanken-Tafel auf dem iMac plötzlich nicht mehr erreichbar, Rails hat nur noch 403 gemeldet. Der Rechner hatte sich beim Neustart selbst umbenannt, und den neuen Namen kannte keine meiner Startdateien. Schuld war der Apple TV im Büro. Der hat als Schlafwächter die alte Namensanmeldung am Leben gehalten, also fand der Mac seinen eigenen Namen belegt und hat einfach hochgezählt. Ich hab keine einzige Datei angefasst, sondern dem iMac seinen alten Namen zurückgegeben und das Aufwachen per Netz abgeschaltet. Jetzt läuft alles wieder, und der Apple TV darf zurück an den Beamer, ohne dass der Geist wiederkommt.
Ich hab eine fertige HTML-Vorlage aus Open Design in eine React-App übertragen, zwölf Abschnitte, die Inhalte als Daten, Farben und Schriften unverändert. Im Browser sieht sie aus wie das Original. Und dann hab ich gemerkt: React will ich gar nicht. Ich arbeite mit Rails, Tailwind und ERB, also bleibt das Projekt erstmal als Vergleich liegen. Mitgenommen hab ich trotzdem was: Eine DESIGN.md ist keine Notiz, sondern eine Vorschrift mit acht Prüfregeln, zum Beispiel für den Kontrast. Und die kann ich genauso auf ein Rails-Projekt loslassen.
Wer Tabellen aus dem Terminal kopiert, kennt das: Überall Striche, egal ob in der Gedanken-Tafel, bei Substack oder auf GitHub. Das Problem sitzt an der Quelle, denn das Terminal kann kein HTML, also malt es Rahmen und die Tabelle ist schon beim Kopieren kaputt. Deshalb hab ich den tabellen-bereiniger gebaut, einen kleinen Wächter auf dem Mac, der die Zwischenablage nach dem Kopieren gleich in eine echte Tabelle umwandelt. Dazu gibt es eine Chrome-Erweiterung, und meine Gedanken-Tafel erkennt solche Tabellen jetzt selbst beim Einfügen. Richtig dicht war das Ganze erst, als ich es mit einer ganz anderen Testtabelle probiert hab, Berlin und Wien statt meiner eigenen Beispiele.
Mein Chatraum ist jetzt offen für Gäste, ein eigener Chat statt ein gemieteter. Wer vorbeikommt, sieht zuerst ein Schaufenster und kommt über einen Knopf direkt als Gast rein. Über dem Knopf steht mein Satz: „Wir brauchen nicht warten, dass uns jemand eine Lösung präsentiert. Wir sind die Lösung.“ Die Begrüßung redet nicht wie eine Person, denn da spricht die Gemeinschaft, und selbst erleben ist besser als erklärt bekommen. Ich hab das ausgerollt, obwohl schon Leute drin waren, weil die sieben Tage Probezeit sowieso der Testraum sind.
In meiner Gedanken-Tafel markiere ich jetzt einfach Text in einer Notiz und schicke ihn mit einem Klick in ein Thema. Der Ausschnitt landet als eigene Notiz oder gleich in der Karte des Themas, und dabei steht, wo er herkommt. Das Themenfenster bleibt offen stehen, während ich aus einer Notiz nach der anderen hineinsammle. Bei offener Karte gibt es dafür nur noch einen Knopf, die lange Liste ist weggeklappt. Weniger zeigen, mehr tun, so wächst ein Thema beim Lesen von ganz allein.
Meine Gedanken-Tafel kann jetzt Hashtags. Ich schreib irgendwo im Text ein Wort mit Raute davor, und schon ist das eine Kategorie, nach der ich oben mit einem Klick filtern kann. Die Suche läuft live mit, während ich tippe. Wichtig war mir dabei: Der Text bleibt die Wahrheit, die Kategorien leiten sich nur daraus ab. So kann ich einfach drauflos diktieren und muss hinterher nichts von Hand einsortieren.
Manche Webseiten machen mich einfach unruhig, weil überall Werbung, Tracking und Kommentarspalten sind. Deshalb hab ich mir Ruhepol gebaut, einen kleinen Filter auf meinem eigenen Rechner, der das alles rausnimmt und Bilder in Graustufen zeigt. Nach 3.000 Zeichen kommt eine Lesebremse, damit ich nicht endlos weiterscrolle. Es gibt zwei Modi: Ruhe läuft ganz ohne Skripte, und Offen ist für Seiten, die ohne Skripte gar nichts anzeigen. YouTube klappt da noch nicht, das ist die nächste Baustelle.
Die Nacht hab ich abwechselnd am Handy und am iMac an meinem Chatraum gebaut. Jetzt gibt es einen Admin-Bereich, eine Befehlsliste, sobald man / tippt, und die flüchtige Runde: ein Gruppenchat wie früher bei ICQ, der eine Minute nach dem Letzten einfach verschwindet. Keine Emojis, keine Zitate, kein „gelesen von“, genau diesen Lärm will ich draußen haben. Die Hausordnung lautet: nichts speichern, was nicht gespeichert werden muss. Drei Stunden Planung in einer anderen Session haben nichts gebracht, hier einfach loslegen hat funktioniert.
Unten in meinem Terminal läuft jetzt eine eigene Statuszeile für Claude Code. Eine farbige Leiste zeigt mir, wie voll das Kontextfenster ist, von Grün über Gelb bis Rot. Daneben stehen die Rate Limits mit der Uhrzeit, wann sie wieder frei sind, die Kosten der Sitzung, die geänderten Zeilen, der Ordner und der Git-Branch. Weil das Ding alle fünf Sekunden neu läuft, hab ich drauf geachtet, dass es mit möglichst wenigen Prozessen auskommt. Und es liest Git so aus, dass es meinen eigenen Befehlen nicht in die Quere kommt.
Ich hab mir Daniel Miesslers Daemon geholt und daraus mein Weglasser-Radar gemacht. Die erste Idee war ein Selbstporträt, das wollte ich nicht, ich brauche kein Mission-Statement über mich. Ich will sehen, was andere machen und wo sie schreiben. Jetzt stehen da elf Weglasser, neun junge Projekte und drei Jagdgründe drin, jeder mit Links zu Webseite, Blog, GitHub und Social. Die 18 Kanäle sind echte Feeds, nachgeprüft statt geraten.
Heute habe ich Rails mit Hotwire auf meinem Rechner eingerichtet und eine klare Linie gezogen. Alles, was man liest, wie stevennoack.de, bleibt bei Astro. Alles, was man bedient, also Formulare, Zustände und eine Datenbank, baue ich ab jetzt mit Rails. Der Grund ist einfach: Der Server schickt fertiges HTML, und damit fällt die ganze Kleberschicht weg, keine JSON-Schnittstelle, kein Build-Schritt, kein Node. Weniger Teile heißt weniger, was mir kaputtgehen kann. Der erste echte Praxistest mit einem eigenen Projekt steht noch aus.
Ich diktiere mit FluidVoice, und das Sprachmodell dahinter läuft bei mir auf dem eigenen Rechner, nicht in irgendeiner Cloud. Jetzt gibt es dafür eine neue Taste: Ich spreche Deutsch, und auf dem Bildschirm steht englischer Text. Drauf gekommen bin ich durch Zufall, weil das Modell bei einem leeren Prompt von sich aus angefangen hat zu übersetzen. Auf Glück will ich mich aber nicht verlassen, also hat das Übersetzen jetzt ein eigenes Profil mit einer klaren Anweisung. Nebenbei habe ich aufgeräumt und 4,3 GB alte Modellreste gelöscht. Die ganze Sprach-Werkstatt liegt jetzt komplett lokal auf meiner SSD, und mieten muss ich dafür nichts.
Die Modelle von FluidVoice haben auf meiner internen Platte 3,3 GB belegt, jetzt liegen sie auf der externen SSD. Kopiert, per SHA-256 geprüft, am alten Ort einen Symlink gesetzt, und die App findet alles wieder, ohne dass ich an ihr irgendwas umstellen musste. Dabei hab ich mir angeschaut, was da eigentlich drinsteckt. fluid-1 ist kein Google-Modell, sondern ein eigenes Feintuning von ALTIC auf Gemma-Basis, trainiert auf über 100.000 Diktate, vermutlich englische. Deutsch klappt nur, weil die Basis mehrsprachig ist. Wer weiß, was auf seinem eigenen Rechner läuft, entscheidet besser, was er damit macht.
Auf meinem eigenen Server war der Proxy vermutlich seit Wochen komplett aus. Schuld war eine einzige Zeile, die noch auf einen Dienst zeigte, den ich bewusst abgeschaltet hatte. Nginx will beim Start jeden dieser Verweise auflösen, und wenn einer ins Leere geht, fallen alle Seiten auf einmal um. Ich hab die Datei nicht gelöscht, nur umbenannt, damit ich jederzeit zurück kann. Nebenbei hab ich gelernt, Fehlercodes richtig zu lesen: Eine 500 heißt, der Proxy hat die Anfrage sauber zugestellt und die App dahinter hakt, ein kaputter Proxy hätte 502 oder 504 geliefert.
In meinem Intel-iMac steckt eine eigene Grafikkarte, eine AMD Radeon Pro 5500 XT mit 8 GB. Ollama hat sie nie angefasst, das Modell lief auf 100% CPU und entsprechend zäh. Also habe ich mir llama.cpp selbst gebaut, mit Vulkan als Antrieb für die Karte. Metal stürzt auf der AMD ab, weil es für Apple Silicon gemacht ist, Vulkan dagegen läuft. Jetzt lädt der Server das Modell in unter 3 Sekunden auf die Grafikkarte. Damit ist auch klar, warum Ollama und LM Studio AMD auf dem Intel-Mac gar nicht erst anbieten.
Mein Nachtbetrieb hat wochenlang still vor sich hin gestreikt, ohne dass es jemand gemerkt hat. Das Logbuch wurde seit dem 03.08. jede Nacht nicht gebaut, weil launchd den Weg zu node nicht kannte. Der Abgleich meines Vaults brach ab, weil ein Python-Modul fehlte. Beides habe ich repariert und live nachgeprüft. Wer seine Dienste selbst betreibt, muss eben auch selbst nachschauen, ob sie nachts wirklich arbeiten.
In meinen Werkzeugkasten kommt jetzt nur noch, wer den persönlichen Link aus der Bestätigungs-Mail hat. Wer ohne gültigen Link kommt, landet still auf der Anmeldeseite, ohne Fehlermeldung. Wer einen geteilten Link anklickt, ist für mich ein Interessent und kein Einbrecher. Neu drin sind zwei Werkzeuge: eine Vorlage für eigene Skills und ein Skill zum Anonymisieren. Jede Karte trägt jetzt ihr Datum, damit man sieht, was frisch ist. Den Zugang habe ich selbst gebaut, mit signierten Links statt einem gemieteten Mitgliederbereich.
Mein Vault hat zwei neue Schutzmechanismen bekommen. Notizen können jetzt ein Verfallsdatum tragen, und der stündliche Digest meldet sich, wenn eins abläuft. Dazu läuft nachts eine Prüfung, die nach Widersprüchen, verwaisten Notizen und fehlenden Querverweisen sucht, aber nur in dem, was ich in den letzten 14 Tagen geändert habe. Geändert wird dabei nichts, die Befunde landen als Vorschlagsliste in meiner Inbox. Der erste Probelauf hat gleich zwei veraltete Stellen gefunden, die ich direkt korrigiert habe. Die Lehre dahinter: Wo es eine Quelle gibt, verlinke ich, statt abzuschreiben.
Ich habe eine Lernseite fürs Terminal gebaut, die jetzt auf stevennoack.de läuft. 10 Missionen führen von pwd bis zu einem simulierten Gespräch mit Claude Code, und der Fortschritt bleibt im Browser gespeichert. Das kleine Terminal dahinter habe ich selbst geschrieben, eine fertige Bibliothek wäre für 8 Befehle einfach zu viel gewesen. Danach habe ich die Seite selbst durchgespielt und drei Stellen gefunden, an denen man hängen bleibt, obwohl technisch alles stimmte. Jetzt sagt eine Fehlermeldung zum Beispiel, wo die Datei liegt und was man tippen soll. Wer das schwarze Fenster noch nie aufgemacht hat, braucht einen Wegweiser, keine Diagnose.
Ich wollte eine Nachricht nur signieren, ohne sie an fremde Nostr-Relays zu schicken. Dabei kam raus, dass mein Skript das nie konnte, weil Signieren und Senden von Anfang an im selben Aufruf steckten. Jetzt gibt es dafür einen eigenen Schalter, und die signierte Nachricht liegt auf meiner eigenen Domain. Die Signatur der ausgelieferten Datei habe ich geprüft, sie stimmt. Mein Supermarkt, nicht das fremde Regal.
Mein Schnittskript sollte den Ton auf minus 14 LUFS bringen. Ich hab nachgemessen, und es landete bei minus 15,3, das Original hat sogar übersteuert. Der Grund: Ein einzelner Durchgang schätzt nur, statt vorher zu messen. Jetzt läuft es in zwei Durchgängen, erst messen, dann anpassen, und die Endfassung bleibt sauber bei minus 0,2 dBTP. Damit ist die Zahl eine Messung und keine Absicht mehr.
Nachmittags hatte ich drei KI-Modelle im Schreib-Blindtest, abends folgte der Programmier-Wettbewerb. Vier Modelle von drei Anbietern bekamen dieselben Aufgaben. Die Lösungen liefen auf meinem Rechner gegen versteckte Testfälle. Nicht raten, messen.
Runde 1: eine Funktion für URL-Kürzel mit deutschen Umlauten, eine zum Verschmelzen von Zeitspannen. Alle vier fehlerfrei, auch bei den Randfällen. Erste Lehre: Ein Test, den alle bestehen, misst nichts. Also Runde 2, absichtlich gemein. Ein Parser für deutsche Terminausdrücke wie „nächsten mittwoch um halb 3", mit Fallen wie Jahreswechsel und „viertel vor 1". Jetzt trennte sich das Feld. Claudes Opus war am schnellsten und fehlerfrei, GPT und Kimi solide. Nur das Code-Spezialmodell von Kimi patzte bei einer Falle.
Zwei Nebenfunde. Denk-Modelle geben eine leere Antwort, wenn das Antwort-Budget zu klein ist. Sie verbrauchen alles fürs interne Nachdenken und schweigen dann. Und: Einer meiner Testfälle lag außerhalb der eigenen Aufgabenregeln. Ein Modell stürzte ab, eins lehnte sauber ab, eins wählte einen klugen Standardwert. Diese Reaktion auf Unklares sagte mehr aus als alle regulären Tests.
Durchgeführt hat das Ganze Claude. Am Modell-Router des Dashboards ändert sich trotzdem nichts. Die Code-Schublade bleibt bei GPT.
Beim Durchgehen meines eigenen Verkaufstexts sind mir zwei Muster aufgefallen, die ich vorher nicht auf dem Schirm hatte. Verräter 8 ist das Katastrophisieren, also Absolutwörter, bei denen man sofort widersprechen will. Verräter 9 ist der inszenierte Gänsehaut-Moment. Beide stehen jetzt auf meiner KI-Slang-Checkliste, öffentlich und im Gratis-Download. Die Prüffrage für Nummer 8 ist simpel: Kann jemand dagegen Einspruch erheben? Wenn ja, fliegt der Satz raus oder wird ehrlicher.
Ich hab den Verkaufstext für den Website-Bauplan einmal komplett Satz für Satz durchgekämmt, statt immer nur hier und da zu flicken. Jedes kleine Nachbessern hat neue Floskeln reingeschleppt, deshalb lieber ein Durchgang am Stück. GitHub und Cloudflare stehen da jetzt nicht mehr als Fremdwörter, sondern als feuerfester Schrank und als Haus an der Straße. Gelernt hab ich dabei: Die vorsichtigeren Sätze verkaufen besser, weil keiner sie bestreiten kann. Der Preis ist von 99 auf 199 Euro gestiegen, und das Kaufdokument baut jetzt die Tür für die Maschinen gleich mit.
Mir ist etwas aufgefallen: Ich recherchiere ein Thema, tauche tief ein, und am nächsten Tag steckt der Kopf in etwas anderem. Der Faden reißt nicht, er fällt nur hinunter. Der einzige Ort, der sich an ihn erinnert, ist der Browser-Verlauf, und den fragt nie jemand.
Ab heute schon. Ein kleines Skript ohne KI liest jede Nacht den Verlauf des Vortags aus meinem Chrome und destilliert ihn: pro Website die Zahl der Besuche, dazu die Seitentitel mit Zählern. Kein Klick-Protokoll, keine Adress-Parameter, nur das Muster des Tages. Der erste Testlauf zeigte mir 462 Aufrufe auf 33 Websites, und ich konnte meinen eigenen Tag darin lesen wie eine Landkarte.
Die Zähler sind der eigentliche Witz. Wenn ich in einer Woche fünfmal dasselbe Video aufrufe, ist das kein Zufall, das ist Verdichtung. Genau danach sucht der nächtliche Gedächtnis-Lauf jetzt: Er legt die Recherche-Muster der letzten Tage neben das, was tatsächlich gebaut wurde, und benennt offene Fäden. Liest seit drei Tagen über X, gebaut wurde aber Y. So ein Satz in der morgendlichen Notiz ist Gold wert.
Und weil heute Vormittag hier das Schleusen-Prinzip stand, gilt es auch hier, nur umgekehrt: Diese Notizen entstehen in der privatesten Schicht meines Zettelkastens und bleiben dort. Die Maschine, die dieses öffentliche Logbuch baut, kann sie technisch nicht sehen. Der Verlauf träumt mit, aber er spricht nicht mit.
Als hätten wir an Lagern nicht genug, entsteht gerade das nächste Paar: pro KI und contra KI. Erst wird ein Thema zur Identität, dann zur Front. Ich beobachte das mit einer gewissen Traurigkeit, denn beide Seiten schreien so laut, dass man das Interessanteste überhört: Es gibt einen dritten Stuhl.
Ein Teil der Angst ist, glaube ich, eine Kränkung. Kopernikus nahm uns die Mitte des Weltalls, Darwin die Sonderstellung in der Natur, Freud die Herrschaft im eigenen Kopf. Jetzt wackelt das Denk-Monopol, und das kratzt am Selbstbild. Jede dieser Kränkungen hat die Welt am Ende größer gemacht statt kleiner. Demut war noch nie ein Verlust.
Ein anderer Teil der Angst ist schlicht berechtigt. Menschen fürchten um ihre Arbeit, ihre Daten und ihre Handlungsmacht gegenüber Konzernen. Diese Sorgen verdienen keine Gegenrede und auch keine Beschwichtigung. Sie verdienen Gebäude.
Genau das ist der dritte Stuhl: KI benutzen, aber zu den eigenen Bedingungen. Die Oberfläche läuft auf dem eigenen Rechner, der Speicher bleibt im eigenen Haus, und die Anbieter sind Gäste, die man einzeln hereinlässt und wieder hinauswirft. Sensibles bleibt beim lokalen Modell, Veröffentlichtes trägt die eigene Unterschrift. Dieses Logbuch ist selbst so ein Gebäude.
Wer auf dem dritten Stuhl sitzt, muss die Spaltung nicht gewinnen. Er macht sie überflüssig, einen Leser nach dem anderen. Man streitet nicht mit einem Lager, wenn man stattdessen zeigen kann, wie das Haus aussieht, in dem beides Platz hat: die Technologie und die Souveränität dessen, der sie empfängt.
Mein Zettelkasten ist tagesaktuell, meine Website war es nicht. Diese Lücke schließt das Logbuch, das du gerade liest. Einträge entstehen direkt aus der Arbeit, eine KI schreibt sie am Ende einer Session, nachts werden sie veröffentlicht.
Die wichtigste Entscheidung dabei war keine technische. Die Veröffentlichungs-Maschine darf meinen Zettelkasten nicht sehen. Sie liest genau einen Ordner, und in diesen Ordner wird aktiv hineingelegt. Privates bleibt nicht privat, weil ein Filter gut funktioniert. Es bleibt privat, weil es für die Maschine gar nicht existiert. Dazu kommen ein Veto-Fenster von vier Stunden und eine Sperrliste, die den ganzen Lauf abbricht, sobald ihr etwas begegnet, das nicht nach draußen gehört.
Jeder Eintrag trägt eine mathematische Unterschrift mit meinem Schlüssel. Das heißt: Du kannst nachprüfen, dass ich das geschrieben habe und dass niemand unterwegs ein Zeichen verändert hat. Beim Test haben wir probeweise eine einzige Zahl im Inhalt gefälscht, und die Prüfung schlug sofort an. Die Signatur braucht dafür kein Netzwerk und keine Plattform, nur die Datei und meinen öffentlichen Schlüssel.
Wenn du das nachvollziehen willst: Dieser Eintrag liegt als signierte Datei neben dieser Seite. Lade ihn, prüfe ihn, ändere ein Zeichen und prüfe noch einmal.
Am Vormittag entstand hier das Logbuch, am Nachmittag habe ich die Werkstatt dahinter entrümpelt. Auslöser war ein Blick auf den Kontextverbrauch: Die teuerste Zutat meiner KI-Arbeit sind Tokens im Hauptmodell, und die flossen zu großen Teilen in Dinge, die kein teures Modell braucht.
Drei Funde. Erstens: 21 Server-Konfigurationen, die seit Monaten nichts taten, weil sie im falschen Abschnitt der falschen Datei lagen. Wirkungslos, aber voller echter Schlüssel und Zugangsdaten. Tote Konfiguration ist nie neutral: Entweder sie verwirrt, oder sie leckt. Jetzt liegt sie unter Verschluss im Archiv statt offen im Weg.
Zweitens: Sieben Cloud-Anbindungen, die in jeder Terminal-Sitzung mitgeladen wurden, obwohl ich sie dort nie benutze. Ein einziger Schalter legt sie still, im Browser-Chat laufen sie weiter. Dazu eine Notiz im Gedächtnis der KI, damit künftige Sitzungen wissen, dass die Werkzeuge absichtlich fehlen und wie sie zurückkommen.
Drittens, und das ist der eigentliche Umbau: Arbeitsteilung nach Preis. Das große Modell denkt, plant und schreibt. Die mechanische Arbeit, etwa Browser-Klickerei und Seiten-Ausleserei, übernimmt ab jetzt ein günstigeres Modell als Unterarbeiter mit eigenem Kontext. Dazu ein lokales Browser-Werkzeug, das Seiten als Text liefert statt als Bildschirmfotos, ohne Cloud und ohne Zusatzkosten.
Der erste Test: Ein Unterarbeiter las die komplette Artikel-Übersicht meiner Website aus, 22 Einträge mit Datum, in 19 Sekunden. In meiner Hauptsitzung kam nur die fertige Liste an, ein Bruchteil dessen, was dieselbe Aufgabe morgens mit Bildschirmfotos gekostet hatte.
Die Regel dahinter hatte ich morgens schon aufgeschrieben, ohne zu merken, dass sie auch hier gilt: Es zählt, wem die Mitte gehört. Der teure Kontext ist die Mitte. Alles, was dort nicht denken muss, bekommt einen eigenen Raum.
Die meisten Websites sperren KI-Crawler aus. Ich gehe seit heute den anderen Weg. Jeder Logbuch-Eintrag liegt jetzt zusätzlich als Markdown-Rohfassung für Maschinen bereit. Dazu gibt es einen RSS-Feed und eine llms.txt. Die erklärt KI-Systemen, was auf meiner Seite liegt und wie man die kryptografischen Signaturen der Inhalte prüft.
Unter jedem Eintrag stehen jetzt vier Links: ChatGPT, Claude, Perplexity und Grok. Ein Klick öffnet den Dienst mit einer fertigen Frage: Lies diesen Text und sag mir, warum er wichtig ist und was du davon hältst. Nenn auch Gegenargumente.
Ich lade also fremde KIs ein, meine Texte kritisch auseinanderzunehmen, direkt hier auf meiner eigenen Seite. Mein Gedanke dahinter: Ein Text, der kritische Fragen nicht aushält, gehört nicht ins Netz. Und jeder Klick trägt meine Inhalte in ein KI-System, samt Beleg, dass sie von mir stammen.
Mein KI-Dashboard entscheidet seit heute selbst, welches Modell antwortet. Ein kleines, schnelles Modell schaut sich die Frage an und reicht sie weiter: Code hierhin, Recherche dorthin, Kreatives woanders hin. Nur bei einer Frage war ich unsicher: Wer schreibt eigentlich am besten? Im Internet stand ganz oben ein offenes Modell namens Kimi, das ich noch nie benutzt hatte. Das konnte ich nicht glauben.
Also getestet: dieselbe Aufgabe an drei Modelle, ein kurzer Text über eine KI, die nachts von allein weiterarbeitet. Die Ergebnisse bekamen nur Buchstaben, A, B und C. Ich habe gelesen und A gewählt. Und je öfter ich A las, desto besser gefiel es mir. Der beste Satz stand da drin: „Ich zog den Stecker nicht."
A war Kimi. Die Liste, der ich nicht geglaubt hatte, hatte recht. Das hätte ich nicht erwartet.
Und noch etwas: Gebaut hat den Test Claude. Sein eigener Text lief mit, es hat verloren, und das Ergebnis hat es selbst in meine Tabelle eingetragen.
Heute Mittag bekam mein lokales KI-Dashboard das Websuchen beigebracht. Ich hatte die Einstellungsseite gerade offen und fragte die KI nebenbei, ob sie da auch im Hintergrund rankommt. Konnte sie: Sie schickte die Konfiguration direkt an die Schnittstelle des Dashboards, ganz ohne Klicken. Kurios daran: Mein noch offener Browser-Tab wusste davon nichts. Hätte ich danach auf Speichern gedrückt, hätte ich ihre Arbeit mit meinen alten Formularwerten überschrieben.
Die erste Ausbaustufe suchte über DuckDuckGo, das drosselt automatisierte Anfragen aber schnell. Also zog eine eigene Meta-Suchmaschine als Container ein: SearXNG verteilt jede Anfrage an Google, Wikipedia, Brave und andere und sammelt die Treffer ein. Drei Minuten nach dem Start kassierte der Neuling prompt seine erste Drosselung von DuckDuckGo. Gemerkt habe ich davon nichts, die Suche lief einfach weiter, die übrigen Quellen lieferten.
Jetzt können alle 59 Modelle im Dashboard Fragen zum aktuellen Tag beantworten und zeigen die Quellen dazu. Und die Suche selbst läuft bei mir: kein Konto, kein Schlüssel, kein Cent.
Heute Morgen wollte ich nur mein lokales KI-Dashboard starten. Ein Dienst war tot: Ein Hilfsprogramm zieht sich bei jedem Start die neueste Version seiner Bibliotheken, und Version 2.0 einer Abhängigkeit hatte über Nacht die Schnittstelle geändert. Die Reparatur war eine Zeile, die Lehre ist alt und bewährt: Versionen festnageln statt hochziehen. Es war der dritte Beleg dafür in diesem Monat.
Danach kamen Grok und Kimi dazu. Ich hatte einen Bastelnachmittag erwartet, es wurden zwei Browser-Logins und ein Skript-Aufruf. Jetzt stehen 57 Modelle von fünf Anbietern im Auswahlmenü, dazu ein lokales Llama, das nie ins Internet telefoniert. Alles läuft über Abos, die ich sowieso bezahle, kein Cent pro Anfrage extra.
Der schönste Moment: Kimi, ein Modell aus Peking, las auf meine Bitte den Posteingang meines Obsidian-Zettelkastens. Über mein eigenes Werkzeug, auf meinem Rechner, zu meinen Bedingungen. Die Anbieter sind bei mir Gäste, keine Vermieter.
Nebenbei entstanden: ein aufgeräumter Zettelkasten, eine Einstiegsseite, die sich ab jetzt nächtlich selbst aktualisiert, und dieses Logbuch.